 精选
日记随笔2026-08-17
在短视频时代,我为什么重新开始写博客?
现在还有人看博客吗?在这个短视频和算法主宰注意力的时代,博客或许过时了,但正因如此,它才成为一个缓慢而安静的自留地——不为流量,不为证明什么,只为完整地表达、整理思绪,并让同类在文字里相遇。
博客写作个人表达数字生活
610
小柒
一个写代码的牛马工程师,白天和业务搏斗,晚上捣鼓开源项目。
那是一个周一下午,产品同事在群里发了一段录屏。录屏里,数据列表页滚动时会出现明显白屏,切换筛选条件后页面像被什么东西拖住了几秒。我点开视频,反复拖进度条,手心有点出汗。那个页面我太熟悉了,但是从来没在接近真实数据量的情况下好好跑过。
我打开本地环境,连上预发布数据,开始录制 Performance。几秒钟的滚动里,React 组件渲染占据了大量时间,火焰图里一片密密匝匝的紫色。那一刻我突然意识到,我对 React 性能优化的理解其实停留在“知道很多概念,但不知道从哪里下手”。于是我开始老老实实做测量、查文档、改代码,也踩了不少坑。后来我把这些零散的经验整理成一份笔记,给团队内部分享过几次。现在再回头看,它更像是一张地图,而不是一份清单。
刚开始优化时,我最容易犯的错误就是一上来就翻代码,看哪里不顺眼就改哪里。后来我发现,React 性能优化如果只盯住渲染,很容易漏掉真正影响体验的地方。更合适的做法是先有一个全景,知道问题可能落在哪几个区域。我把它们分成四块:渲染、加载、状态、工具。
渲染,是 React 应用最容易出问题的地方。组件重新渲染次数太多、一次渲染计算量太大、树的分支太深,都会让界面掉帧。比如一个输入框触发父组件更新,导致几百个子组件跟着重渲染;或者一个大的表格没有虚拟化,几千行一次性挂到 DOM 里。渲染层面的手段很多,比如合理的 memo、useCallback、useMemo,组件拆分、派生状态、虚拟列表,以及减少不必要的 props 变化。但手段多不代表每个都要用,哪个阶段适合上什么,要看具体瓶颈。
加载,更多关注资源。首屏 JS 体积、路由代码分割、图片懒加载、字体加载、第三方库按需引入。加载优化不一定影响单次交互,但它决定用户第一次打开时的感受,也影响弱网环境下能不能用。很多时候渲染再快,如果首屏要加载 4 秒的 JS,整体经验也不会好。这个层面的优化往往比较直接,收益也容易被量化,适合作为性能治理的起点。
状态,是性能问题里比较隐蔽的一块。全局状态设计得不好,会让不相干的组件被频繁唤醒;服务端状态没有缓存,会让相同的请求反复发出;一个大的 Context 一旦更新,所有订阅者都会重新渲染。状态层面的优化,往往需要先把状态分布理清,哪些是本地状态,哪些是全局状态,哪些是服务端状态,再决定用什么工具和模式。状态设计好了,很多渲染问题自然消失。
工具,是贯穿始终的。React DevTools Profiler、Performance 面板、Lighthouse、web-vitals、打包分析工具,这些能帮助我们把“感觉慢”变成“确实慢”,并且定位到具体组件或资源。没有工具,性能优化就很容易变成玄学。工具也是我们和团队沟通的共同语言,不然每个人说“卡”都是一个很主观的词。
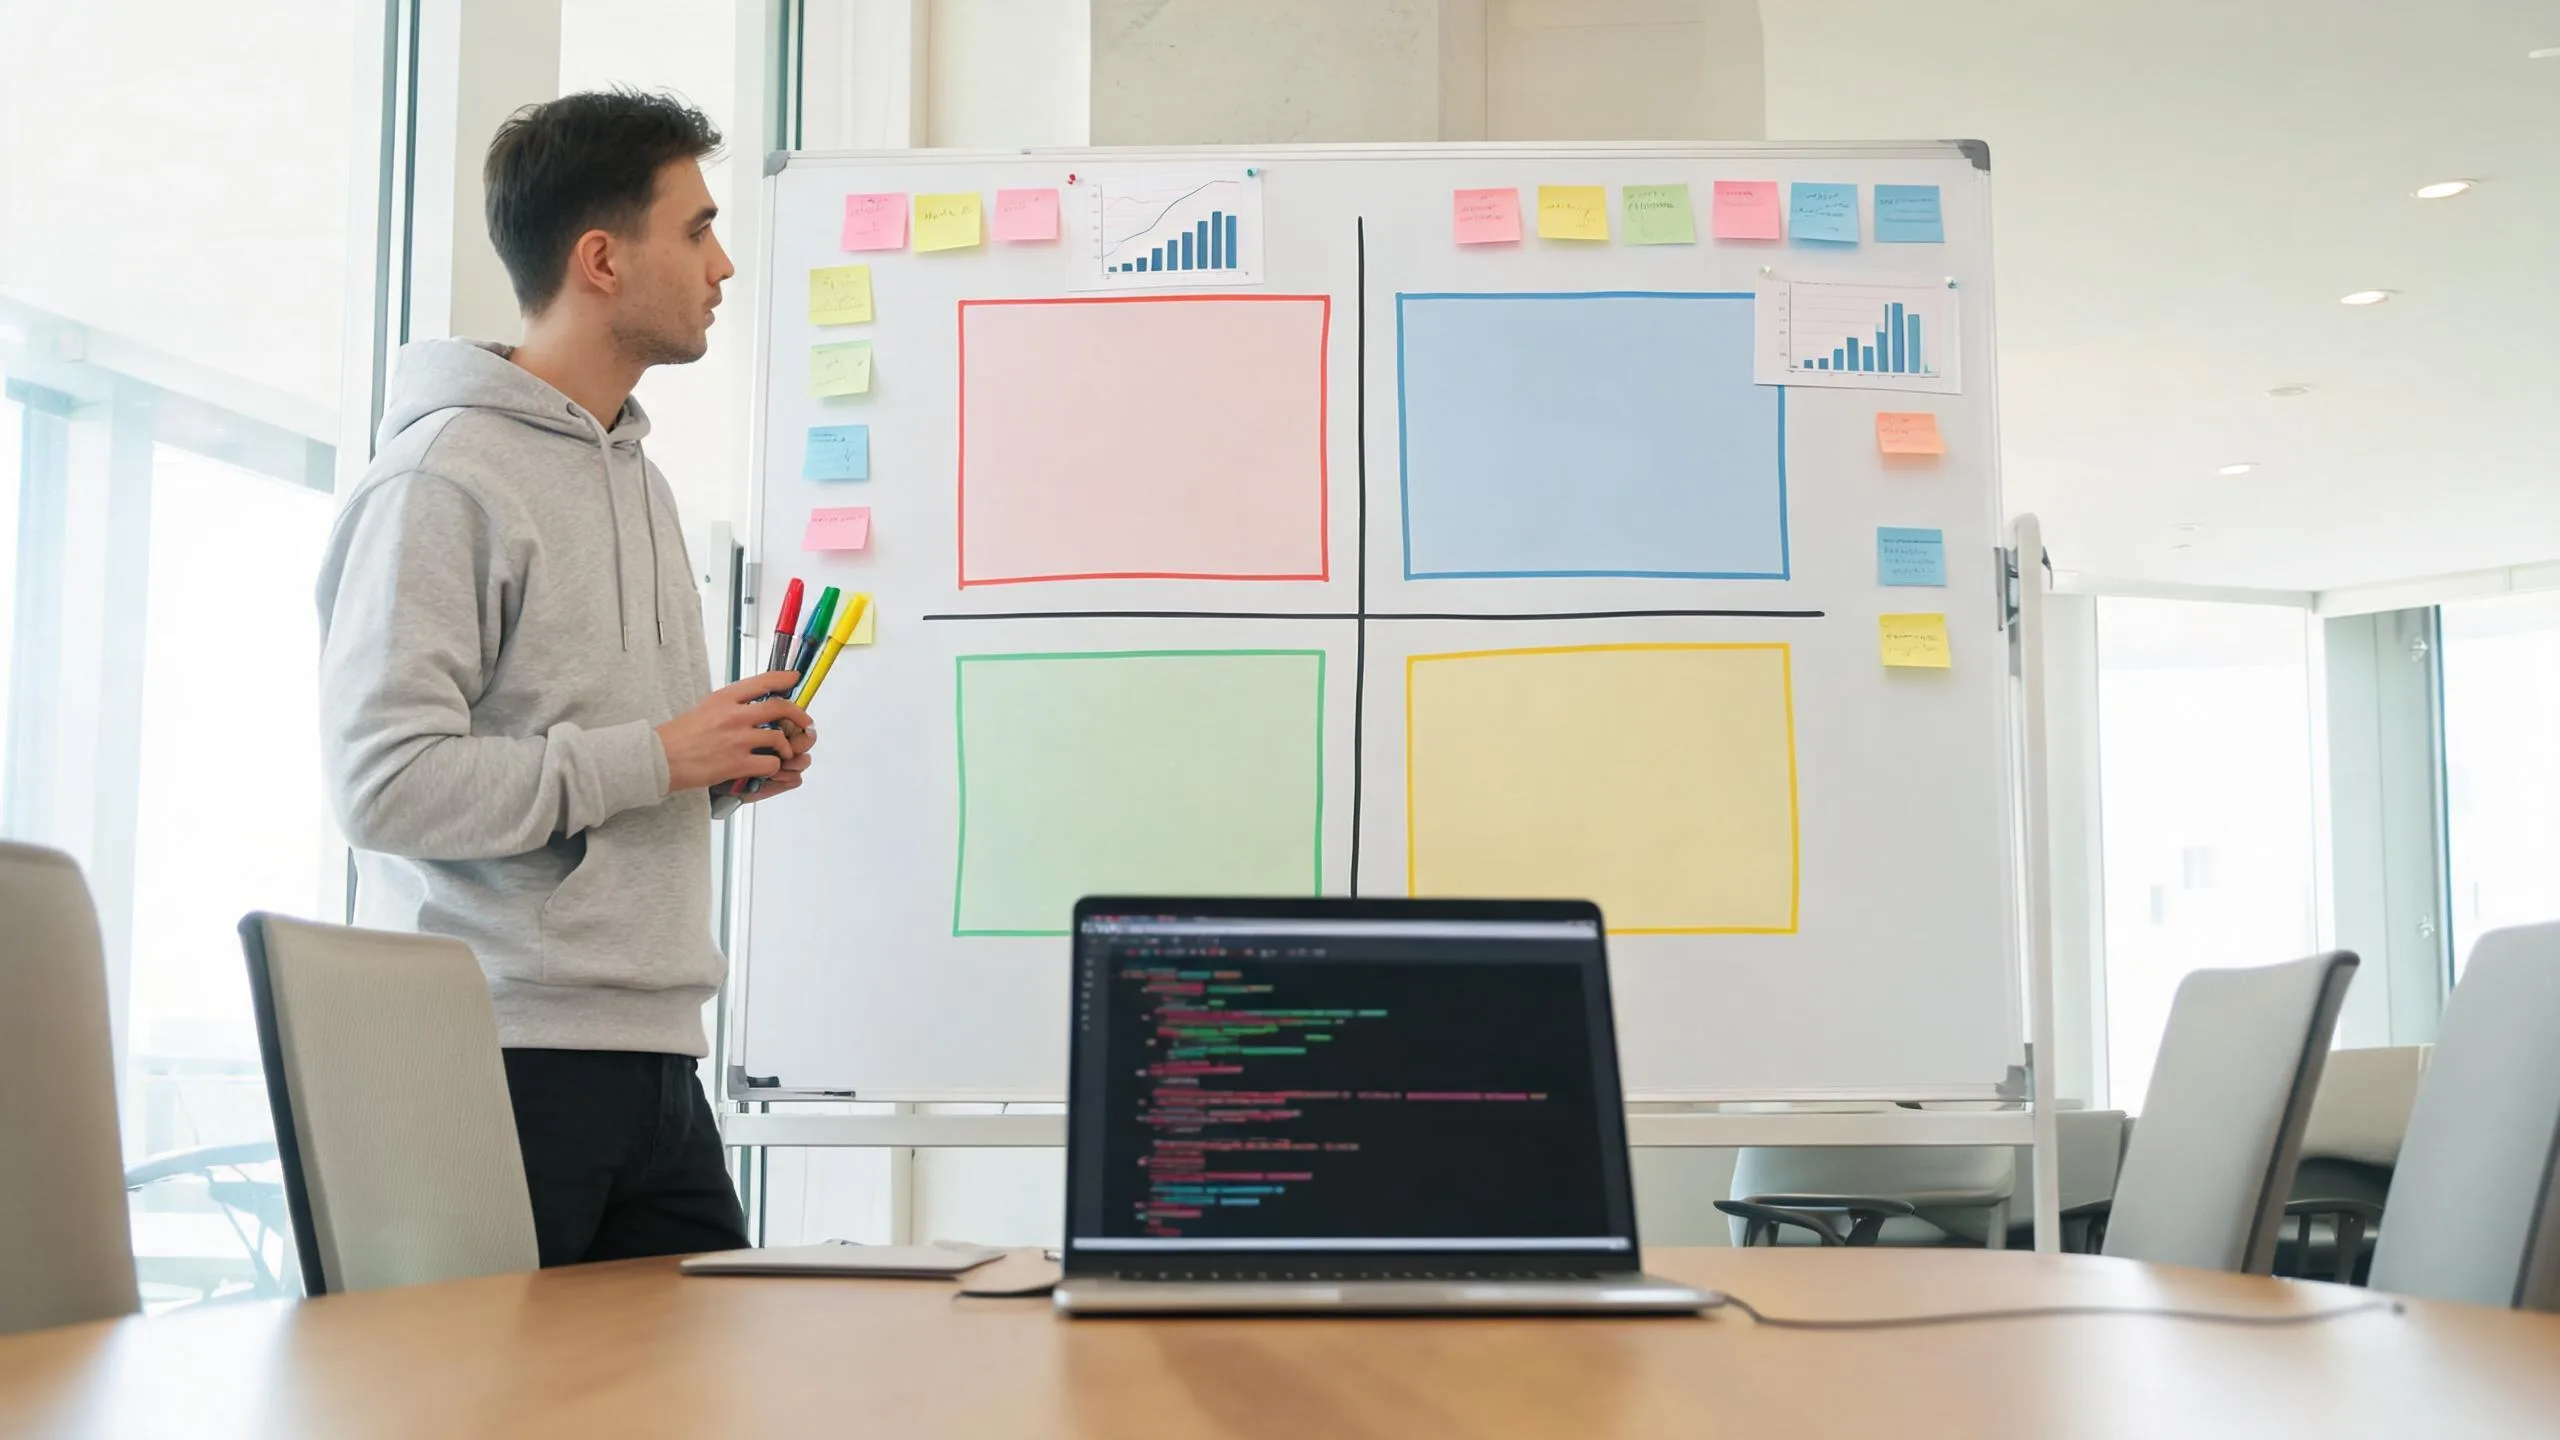
在我自己的实践里,这四个象限不是并列的,而是互相影响。渲染问题经常由状态设计引起,加载问题又会放大渲染问题。所以我把这四块看作一张地图,每次遇到性能问题,先判断它属于哪个象限,再决定深入哪个方向。这个分类不一定严谨,但足够在混乱的优化现场给我一个锚点。
我记得第一次尝试优化那个列表页时,第一反应就是“加 memo”。给列表每一项包上 React.memo,把回调函数都改成 useCallback,依赖数组小心地写,觉得自己在做正确的事。改动了两天,代码复杂了不少,结果滚动性能只提升了一点,有些地方甚至因为依赖数组写错导致状态更新异常。
那段时间我陷入了一个误区:以为 memo 越多越好,以为所有函数都应该包 useCallback。但实际上,memo 本身也有成本。每次渲染时,React 需要进行浅比较,如果 props 总是新的对象或函数,memo 根本拦不住重渲染。有些组件很小,重渲染成本很低,加上 memo 反而增加了比较成本,还降低了代码可读性。useCallback 也有类似问题,如果它是为了稳定引用而稳定引用,但没有传递给 memo 子组件或作为 effect 依赖,往往只是让代码变复杂。
过早优化是另一个坑。有几次我在写新功能时,心里想着“这里以后可能会慢”,于是提前做代码分割、套虚拟列表、把某些状态拆得很细。结果功能上线后数据量根本不大,那些优化除了增加实现成本,没有带来可见收益。更糟的是,它们让后续维护变得更吃力。性能优化不应该是一种直觉上的“提前防御”,而应该建立在实际测量之上。
我现在会更警惕那些“看起来理所当然”的优化。尤其是 memo 的滥用,会让团队成员对性能产生虚假的安全感。真正有效的 memo,往往出现在渲染成本高、props 变化少的组件上;真正有效的 useCallback,通常是为了配合 memo 子组件或作为 effect 依赖。如果只是随手加,不如先看看 Profiler 里这个组件到底占了多少时间。React 团队自己也反复强调过,很多情况下不需要手动优化,React 的默认行为已经足够快。
后来我给自己定了一条小规则:每次想要加 memo 或 useCallback 之前,先问自己两个问题——这个组件真的渲染得很慢吗?它的 props 是不是确实不应该频繁变化?如果两个问题中有一个不确定,就先不动。把代码写简单,有时候比把代码写快更重要。
踩过几次坑之后,我开始强迫自己走一条流程:先测量,再分析,再优化,最后验证。这个顺序听起来很普通,但真的做到并不容易,因为它要求我克制住改代码的冲动。
测量,首先是建立基线。对一个页面来说,我通常会记录几个关键指标:首次内容绘制、最大内容绘制、总阻塞时间、交互到下一帧的延迟。工具可以用 Lighthouse 快速跑分,也可以用 Performance 面板录制真实操作。对于特定的组件渲染性能,React DevTools Profiler 可以告诉我们哪些组件渲染了多少次、每次花了多少时间。测量要尽量接近真实环境,包括真实数据量、真实设备性能、弱网模拟。脱离真实场景的测量,就像在空跑道上测油耗,参考价值不大。
分析,是把测量结果转成问题列表。比如火焰图里一段长任务持续了 200 毫秒,往下展开发现某个表格单元格组件反复渲染;或者网络面板里首屏加载了一个巨大的 vendor 包;或者 Profiler 里一个 Context 更新导致整棵子树重新提交。分析时我会问自己:这个成本是否可以被消除、减少或延迟?它出现在哪一类象限里?是渲染问题还是状态问题,是加载问题还是资源问题。分析得越具体,后面动手改进的方向就越清晰。
优化,就是根据分析结果做针对性修改。这里我会给自己定一个原则:一次只改一个变量。比如先做列表虚拟化,验证后再做图片懒加载,避免混在一起分不清哪个有效。另一个原则是:优先做成本低、收益高的优化。代码分割、懒加载图片、删除重复依赖,通常比重构状态管理来得快。遇到一些改动很大的优化,我会先做小范围实验,确认有效后再铺开。
验证,是回到测量环节,用同样的方式再记录一次指标,看是否真的变好。还要关注是否有回归,比如懒加载导致用户滚动时图片等待,或者 memo 导致状态不同步。验证不只是看数字,也要回到那台录屏的设备上,重新滚一遍页面,感受一下是否真的顺滑了。数字是重要的,但最终体验是数字和感受的共同结果。
在这个过程中,我慢慢形成了一个习惯:每次优化至少留下三个数字——优化前、优化后、变化幅度。数字不会骗人,也不容易在团队沟通中产生歧义。它还能帮助我在几个月后回看时,知道当时为什么做了某个决定。很多性能优化的经验,如果没有数字记录,过段时间就只剩下一个“好像快了一点”的模糊印象。
说一个我最近参与过的项目吧。那是一个面向内部运营的中后台应用,用 React 18 和 TypeScript 写,路由有二十多个页面,核心的几个页面涉及大量数据筛选和表格展示。用户反馈最多的是两个问题:首页首屏太慢,数据列表页交互卡顿。
我先做了测量。用 Lighthouse 在本地和预发布环境各跑了几次,发现首屏 LCP 大约 4.2 秒,总阻塞时间超过 900 毫秒,最大的 JS 包达到 1.8 MB。再用 React DevTools Profiler 录制列表页操作,发现切换筛选条件后,一次提交阶段耗时超过 300 毫秒,其中超过 60% 的时间花在一个 5000 行的表格渲染上。而且表格每一行都直接绑定了一个全局 store 的 getter,导致任何筛选条件变化都会触发所有行的重新计算。
分析之后,我列了一张问题清单:首屏加载了不必要的第三方图表库、没有做路由级代码分割、表格没有虚拟化、全局状态设计过粗、图片没有懒加载。然后我按优先级分成了三轮优化。每一轮只解决一类问题,上线后再看数据,不合适就回退。
第一轮做加载。拆分路由,把图表库改为按需加载,清理掉两个没有被使用的大依赖。首屏 JS 从 1.8 MB 降到 620 KB。加入图片懒加载和字体预连接。首屏 LCP 从 4.2 秒降到 2.1 秒,总阻塞时间降到 400 毫秒左右。这一轮改动相对安全,但收益很大,也给了团队一些信心。
第二轮做列表虚拟化。把那个 5000 行的表格接入 react-window,只渲染可视区域内的行。同时把每一行对全局 store 的直接订阅改成父级计算后通过 props 传入。提交阶段耗时从 300 毫秒降到 60 毫秒上下,滚动时也不再出现明显白屏。这个过程里最花时间的不是写虚拟列表本身,而是理清每一行到底需要哪些数据、哪些依赖会触发更新。数据流理清之后,很多渲染浪费也跟着消失了。
第三轮做状态与渲染细节。把几个频繁变化的全局状态拆到更局部的 Context,避免整棵树重渲染。给一个重型的图表组件加 memo 和稳定的 props,给筛选表单加上受控输入延迟。这一轮之后,交互延迟进一步下降,一些页面在低配笔记本上也基本稳定在 60 帧左右。
这个项目做完后,我把数据整理成一份简短的报告:LCP 降低约 50%,提交阶段耗时降低约 80%,首屏 JS 降低约 65%。但是数字背后的体验变化更明显。之前每次打开页面都要等几秒,现在基本能立即看到骨架屏;之前筛选一次数据列表要卡一下,现在几乎感觉不到。更重要的是,这些优化都不是靠感觉闷头改出来的,而是按照流程一步步来。
中间也有过一次反复。我做虚拟化时,曾经试图一次性改完所有表格,结果出现了一个滚动位置跳变的 bug,测试同学差点把浏览器摔了。后来拆成两个页面分别上线,问题就少了很多。优化不应该是一次性的大手术,而应该是一系列可以随时停下来观察的小步骤。
性能优化做多了,我越来越觉得单靠某个人去救火是低效的。真正能持续维持性能的,是一种团队习惯。后来我在团队里推广了几件小事,效果不错。
第一件事是建立性能预算。我们把几个核心页面的 LCP、总阻塞时间、首屏 JS 体积写进 CI。每次提交如果超出预算,构建会给出警告,甚至阻止合并。预算本身不需要很严格,但它的存在会让大家在写代码时多一个意识。预算要循序渐进,一开始定得太紧,大家会想方设法绕过它;定得稍宽松一些,逐步收紧,反而更容易坚持。
第二件事是每次大改后做一次性能回归。不一定要每次都跑完整的 Lighthouse,但至少录制几秒关键操作,看一眼火焰图。我们把这一步放在 code review 检查项里,和单元测试、可访问性并列。Code review 里多问一句“这个改动有没有可能影响渲染次数”,有时就能挡掉一个潜在的性能退化。
第三件事是分享优化案例。每次有人做了一次有效的性能优化,就在周会上花十分钟讲一下:测量到了什么、改了什么、验证结果如何。这样的分享比较有说服力,也慢慢把“按数据优化”的思维传递给其他人。分享的重点不是“我用了 memo 所以快了”,而是“我测量到一个 200 毫秒的提交,分析是状态设计问题,改成局部状态后降到 40 毫秒”。
这些习惯刚开始推的时候并不顺利,有人觉得性能预算太麻烦,有人觉得周会分享浪费时间。但坚持了几周后,团队成员渐渐形成了一种默契。有一次一个新同事在 review 时主动提出:“这里我们需不需要先测量一下再决定要不要 memo?”那一刻我觉得,性能文化算是扎下了一点根。
现在偶尔看到有人提交一个明显会拖慢首屏的依赖,很快会有同事在下面评论提醒。这不是某个人在把关,而是一种集体的警觉。性能不该是某次专项优化的目标,而应该像代码格式一样,成为日常开发的一部分。虽然它不会总是被优先考虑,但只要有一套轻量的流程和共同语言,就不会轻易滑回“先上线再说”的老路。
现在再回头看那个周一下午的录屏,我其实有点感谢那次卡顿。它逼着我把那些零散的知识点串起来,变成一套可以反复使用的方法。性能优化这件事,说到底并不是为了跑分多好看,而是让使用工具的人少等几秒、少一点焦虑。我们写代码的人,常常太容易沉浸在自己的实现里,忘了最终会有人坐在屏幕前点击、滚动、等待。
测量不是不信任自己的手艺,优化也不是追求极致。它更像是一种持续的觉察:知道自己的应用在哪里慢、为什么慢、以及慢得值不值得。也许下一次再遇到页面卡顿,我会先泡一杯咖啡,打开 Profiler,然后从头来看一遍。毕竟,慢下来观察,常常比急着加速更有效。
觉得不错?分享给朋友吧~
评论提交后需审核通过才会展示;点赞与收藏需要登录。
还没有评论,来抢首条评论